IC的帆哥 - 亲和性 2021-06-28T16:49:00+08:00 Typecho https://www.icfgblog.com/index.php/feed/atom/tag/%E4%BA%B2%E5%92%8C%E6%80%A7/ <![CDATA[大佬的矩阵乘法加速]]> https://www.icfgblog.com/index.php/algorithm/231.html 2021-06-28T16:49:00+08:00 2021-06-28T16:49:00+08:00 icfg66 http://www.icfgblog.com 感谢这篇博文的分享,原理讲得很清楚。大佬是怎么优雅实现矩阵乘法的? github 源码,核心代码用汇编,"sgemm_kernel_x64_fma.S"

由于之前用过avx256指令集做过加速,也了解cpu亲和性方面的知识,于是我便在三台机器上做了尝试,理清了不少东西,顺便记录一番。

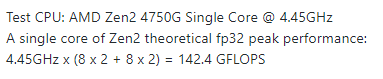
大佬的配置如下,计算性能时有两点需要注意:

  • 为什么是8x2? 利用了avx256寄存器,一次可以处理8个32bit 的float类型数据,2表示乘、加两种运算。
  • 为什么要加两下?单个逻辑核有超标量,一个周期可以处理两个计算指令。理由是“main.c”函数中有绑定cpu亲和性的操作:thread_bind(0),因此只用了一个逻辑核。

image.png

实验一 :性能测试

在自己电脑的虚拟机测试(AMD Ryzen pro 2500u @2GHz): image.png (8,24,16)表示A、B矩阵大小分别为8x16,16x24。总运算量:8x16x24x2=6144次乘加。除以运算时间就是性能:
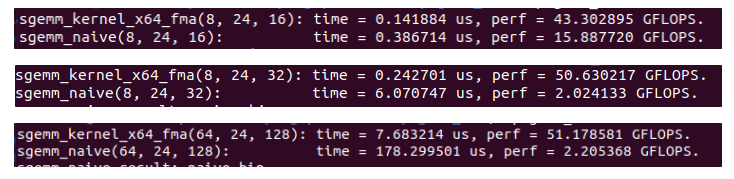
$$ perf = \frac{6144}{0.141884u}=43.303G $$

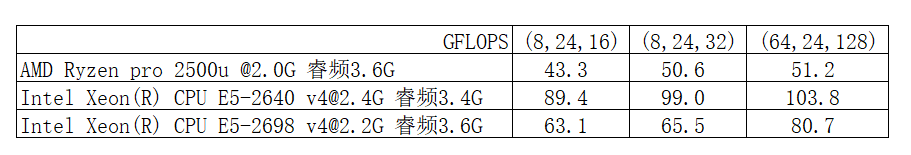
另外两个服务上也做了测试: image.png 貌似第二个服务器的结果更加符合预期,预计峰值

$$ 3.4\times(8\times2+8\times2)=108.8 $$

实验二:Cache

产生差异的原因会和cache有关吗?感觉关系不大,但也顺便探索了一番。

自己笔记本的cache如下,L1=384kB,L2=2.0MB,L3=4.0MB。同时这个cpu是4核8线程,cache如何分布在核上的?
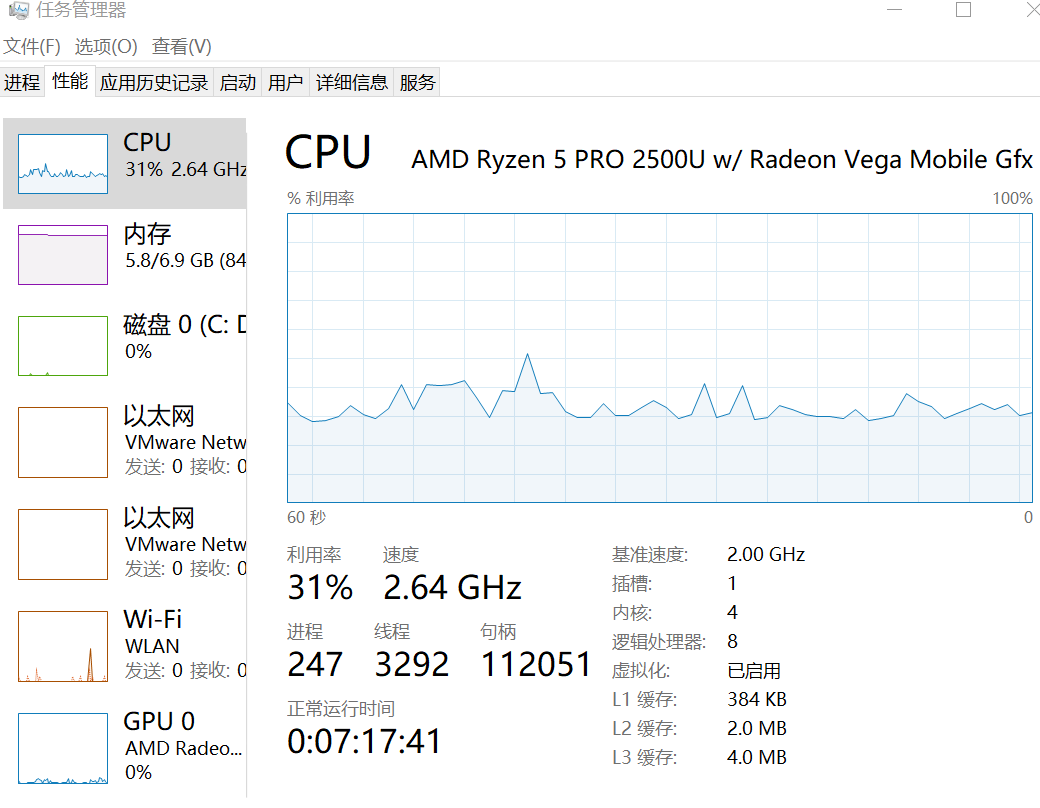
image.png 可以用如下指令查看各级cache的具体分布:

cat /sys/devices/system/cpu/cpu0/cache/index0/size
32k
cat /sys/devices/system/cpu/cpu0/cache/index1/size
64k
cat /sys/devices/system/cpu/cpu0/cache/index2/size
512k
cat /sys/devices/system/cpu/cpu0/cache/index4/size
4096k

发现竟然还有四个index,用指令:getconf -a |grep CACHE继续查看 image.png 发现L1分为指令缓存65536B和数据缓存32768B,为什么不是384kB?
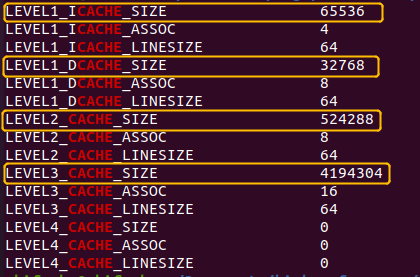
正是因为有4个物理核,上图显示的是一个线程享有的L1,L2,L3。统计4个核的L1,L2,L3(共用),得到如下清晰的结构: image.png 这里需要注意两点:
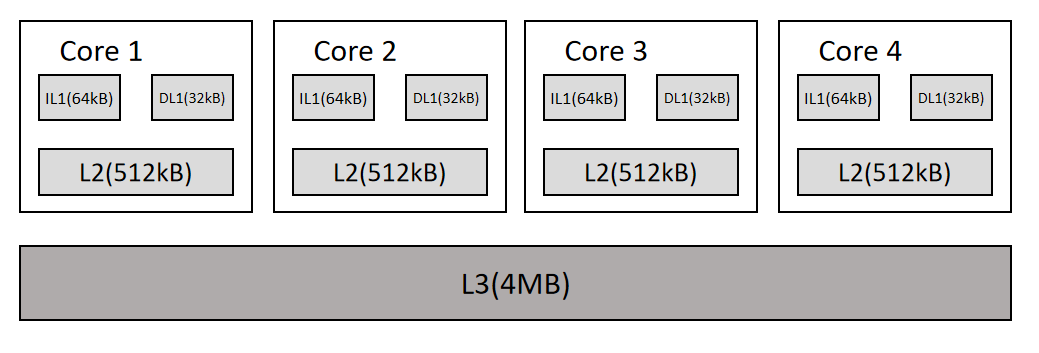
  • IL1和DL1共同构成L1,四个96kB的L1总共有384kB。
  • 这里的k不是1000,而是1024。

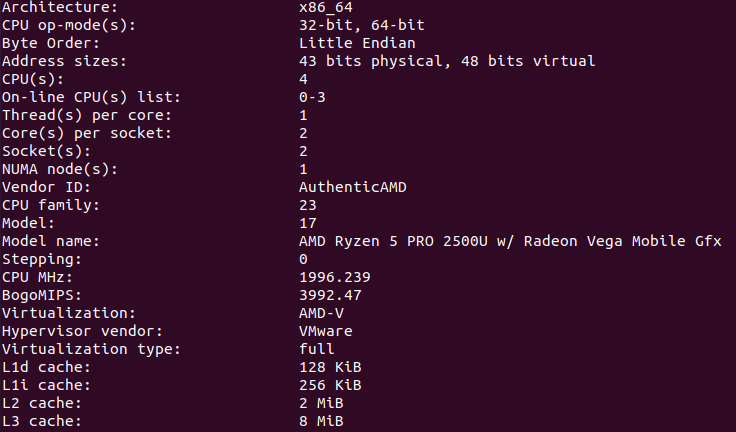
用这个指令交叉验证:lscpu image.png

发现L1d,L1i,L2都符合预期,但L3竟然不是4M,这点不得其解。

总结

经过这番探索,结合之前cpu亲和性的文章,对其结构有更深刻的理解,并能通过linux指令查看验证结构。

]]>
<![CDATA[C++多线程2——亲和性]]> https://www.icfgblog.com/index.php/EDA/120.html 2021-02-08T13:58:00+08:00 2021-02-08T13:58:00+08:00 icfg66 http://www.icfgblog.com

一、多核CPU的结构

服务器的多核结构属于NUMA(Non-Uniform Memory Access,非一致性内存访问)架构。这里有一篇很好的介绍NUMA架构理解。

以我们课题组的服务器为例,上面有两个“插槽”,即两个socket(物理概念),逻辑上称为节点node。

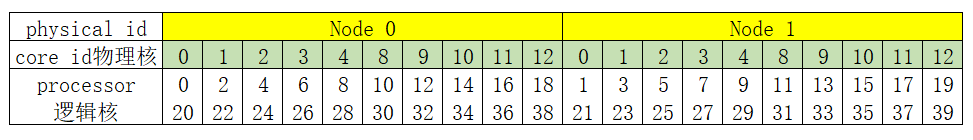
每个插槽10个物理核core,每个物理核通过超线程技术可以产生两个逻辑核processor。

因此我们服务器可以有$ 2 \times 10 \times 2=40$个线程 。

CPU亲和的意思是,假设我们产生40个线程,希望每个线程运行在他们各自的node上或者core上,这样可以减少程序运行时的内存搬运。

二、查看服务器配置

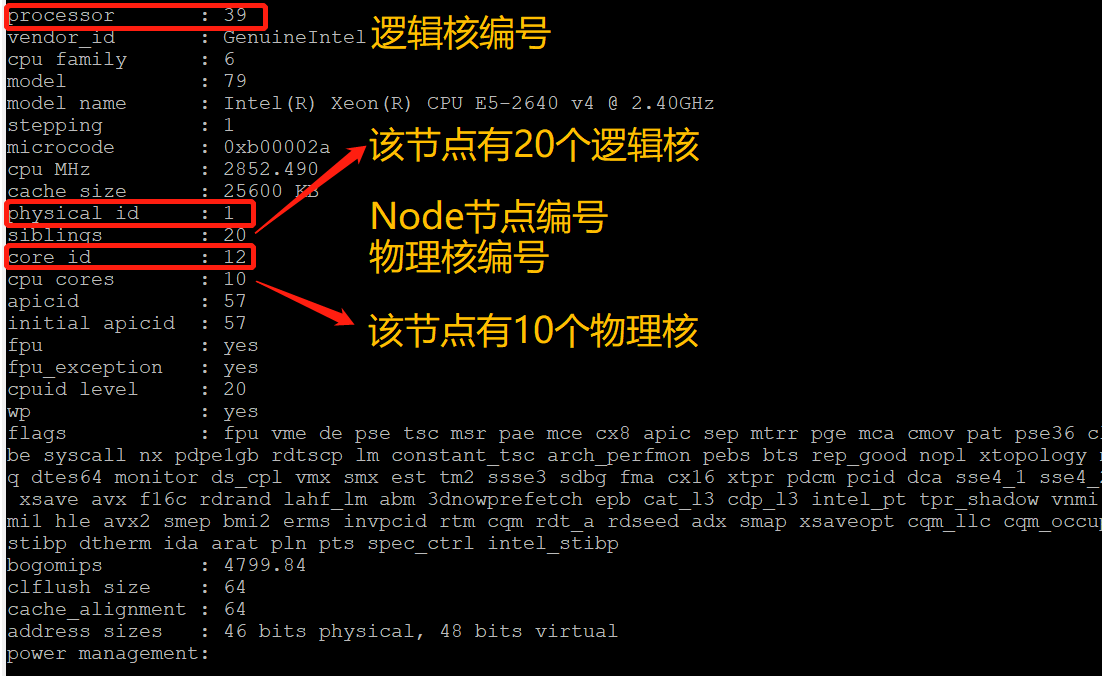
cat /proc/cpuinfo #查看所有processor的信息

core.jpg

这是最后一个逻辑核的信息,总共有40个逻辑核,该逻辑核在node1节点的12号cpu上(这里的编号不一定连续)。所有的逻辑核分布如下:

core2.jpg

因此我们设置线程时,可以绑在同一个node上,即绑在逻辑核编号为{0,2,...,18,20,22,...,38}的集合,或{1,3,...,19,21,23,...,39}的集合,让内存不要在Node0和Node1之间发生。

也可以绑在同一个core上,即绑在逻辑核编号为{0,20},{2,22},{4,24},...,或{19,39}的集合,这样不同物理核之间也不会用内存交换,提高运行速度。

可以用numactl程序查看这些核的分布情况,如没有可以安装sudo apt install numactl,但服务器上我们一般没有root权限,还可以这样查看:

cat /sys/devices/system/node/node0/cpulist
cat /sys/devices/system/node/node0/cpumap

三、设置pthread亲和性

还是用求和的例子说明:

#define _GNU_SOURCE
#include 
#include 
#include 
#include  
#include 
​
const int S = 100000000;
int* arr;
​
typedef struct{
 int first;
 int last;
 int result;
}MY_ARGS;
​
void* mysum(void* args){
 int i;
 int s=0;
 MY_ARGS* my_args = (MY_ARGS*) args;
 int first = my_args->first;
 int last = my_args->last;
​
 for(i=first;i result = s;
 return NULL;
}
​
int main(){
 int i;
 arr = malloc(sizeof(int) * S);
 for(i=0;i

这里将两个线程绑分布绑在node0和node1节点,也可以都绑在同一个节点,因为每个节点最多能跑20个线程,问题不大。

更多实例可以参看我的gitee:pthread亲和性

]]>