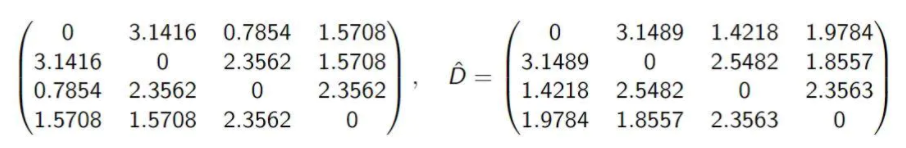IC的帆哥 - 算法 2021-04-13T21:16:00+08:00 Typecho https://www.icfgblog.com/index.php/feed/atom/tag/%E7%AE%97%E6%B3%95/ <![CDATA[AES的五种加密模式]]> https://www.icfgblog.com/index.php/algorithm/179.html 2021-04-13T21:16:00+08:00 2021-04-13T21:16:00+08:00 icfg66 http://www.icfgblog.com AES五种模式 AES五种模式及代码 AES基础C实现 AES四种模式优缺点

在线加密1 在线加密2

美国国家标准与技术协会:AES五种模式及示例 AES子模块详细文档

1.ECB(Elctronic Codebook Book)电码本模式

将明文分成若干相同的小段,然后对每一小段加密。

优点:简单,适合并行,误差不传递 缺点:不能隐藏明文,可能对明文主动攻击

2.CBC(Cipher Block Chaining)密码分组链接模式

将明文切成若干小段,然后每一小段与初始块或者上一段密文进行异或后,再加密。 优点:不容易主动攻击 缺点:不利于并行,误差传递,需要初始向量

3.CFB(Cipher FeedBack)密码反馈模式

优点:隐藏明文,分组密码转为流密码,可及时加密传送小于分组的数据 缺点:不利于并行,误差传递,唯一的IV

4.CTR(Counter)计算器模式

5.OFB(Output FeedBack) 输出反馈模式

优点:隐藏明文,分组密码转流模式,可以及时传送小于分组的数据

缺点:不利于并行,主动明文攻击,误差传递

]]>
<![CDATA[C++多线程4——锁竞争]]> https://www.icfgblog.com/index.php/EDA/125.html 2021-02-08T19:06:00+08:00 2021-02-08T19:06:00+08:00 icfg66 http://www.icfgblog.com

一、为什么要锁

锁是为了防止多线访问共同内存时的冲突问题,先看实例:两个线程分别对全局变量累加:

//gcc lock_test.c -lpthread
#include 
#include 
#include 
​
int num = 0; //设置为全局变量,在全局区域共享
​
void* myfun(void* arg);
​
pthread_mutex_t mtx;
int main()
{
 //1.产生两个线程,分别对全局变量累加
 pthread_t id[2];
 pthread_mutex_init(&mtx,NULL);
 for (int i = 0; i < 2; i++) {
 pthread_create(&(id[i]), NULL, myfun, NULL);
 }

 pthread_join(id[0],NULL); 
 pthread_join(id[1],NULL); 
 printf("%d\n",num);
 return 0;
​
}
​
void* myfun(void* arg)
{
 int i;
 for(i=0;i<100000000;i++){
//  pthread_mutex_lock(&mtx);
 num++;
//  pthread_mutex_unlock(&mtx); 
 }

 return NULL;
}

如果没有加锁,num的结果每次都不一样:

lock1.jpg

如果加锁(myfun的注释部分),最后的结果才正确,但时间会更长。

lock2.jpg

二、锁竞争的妙用

回顾C++多线程前面三篇的例子,我们都是给固定的线程分配任务,然后每个线程完成任务后就销毁,但是如果每个任务的计算量不一样,那么就会造成负载不均衡,先完成任务的线程不能“帮助”后完成任务的线程。

现实生活中,一群人干活,干的快的可以帮助干的慢的,那么在多线程的框架下如何实现呢?

这时候,“锁”的妙用来了!假设我们的任务时计算一万个矩阵的逆,各矩阵间不相关,但大小不一,比较随机。如何让这些线程“互帮互助”呢?

一个很巧妙的方式是,我们仍然设置一个全局累加变量,但需要稍微修改改myfun:

void* myfun(void* arg)
{
 int i;
 while(1){
 pthread_mutex_lock(&mtx);
 i = num;
 if(i>=10000){
 pthread_mutex_unlock(&mtx);
 break;
 }
 num++;
 pthread_mutex_unlock(&mtx);
 task_invmatrix[i];//执行第i个任务
}

各个线程先争夺全局变量num,修改num之后,执行第i(=num)个任务,由于任务的时间远大于加锁、修改num、解锁的时间,这样便实现了各线程的互帮互助!

更多实例可以参看我的gitee:ptread_lock

]]>
<![CDATA[C++多线程3——线程池]]> https://www.icfgblog.com/index.php/EDA/122.html 2021-02-08T18:34:00+08:00 2021-02-08T18:34:00+08:00 icfg66 http://www.icfgblog.com

一、线程池的好处

如果任务的数量一开始不确定,我们该如何开辟线程?如果来一个任务开辟一个线程,任务结束之后又销毁线程,那么整体的效率会很低,大多数时间都在产生和销毁线程,该如何摆脱这种困境?

线程池的概念孕育而生,我们可以一次产生4个线程,它们组成一个线程池,相当于食堂的打菜大妈;接着会有一波任务接连过来,这些线程便依次完成这些任务,如果暂时没有任务,它们也不销毁,继续等待,直到设定的一定之间后,才销毁线程池。

线程池能够大大提高任务执行的效率。

二、线程池实例

如果从头开始写线程池,会非常复杂,目前我也没这个水平。花了很大功夫才找到Github上一个开源的线程池代码,并且用实例跑通了这个线程池,效果还是不错的。

这个线程池需要两个文件thpool.c和thpool.h。还是求和的例子,我们用线程池来实现:线程池有四个线程,1亿个元素分成40个任务,依次加入线程池,然后将40个结果再求和。

// gcc example3.c thpool.c -lpthread -D THREAD_DEBUG
// 正式运行时不需要加 -D THREAD_DEBUG
#include 
#include 
#include 
#include 
#include 
#include "thpool.h"

const int S = 100000000;
int* arr;

typedef struct{
	int first;
	int last;
	int result;
}MY_ARGS;


void mysum(void *args){
	int i;
	int s=0;
	MY_ARGS* my_args = (MY_ARGS*) args;
	int first = my_args->first;
	int last = my_args->last;

	for(i=first;i result = s;
}

int main(){
	
	int i;
	arr = malloc(sizeof(int) * S);
	//1.数据准备
	for(i=0;i

注意这里的mysum函数与pthread中有些不同,void没有加*,也没有return。我们可以自己修改mysum函数来完成不同的任务。

更多实例在我gitee:thread_pool

]]>
<![CDATA[C++多线程2——亲和性]]> https://www.icfgblog.com/index.php/EDA/120.html 2021-02-08T13:58:00+08:00 2021-02-08T13:58:00+08:00 icfg66 http://www.icfgblog.com

一、多核CPU的结构

服务器的多核结构属于NUMA(Non-Uniform Memory Access,非一致性内存访问)架构。这里有一篇很好的介绍NUMA架构理解。

以我们课题组的服务器为例,上面有两个“插槽”,即两个socket(物理概念),逻辑上称为节点node。

每个插槽10个物理核core,每个物理核通过超线程技术可以产生两个逻辑核processor。

因此我们服务器可以有$ 2 \times 10 \times 2=40$个线程 。

CPU亲和的意思是,假设我们产生40个线程,希望每个线程运行在他们各自的node上或者core上,这样可以减少程序运行时的内存搬运。

二、查看服务器配置

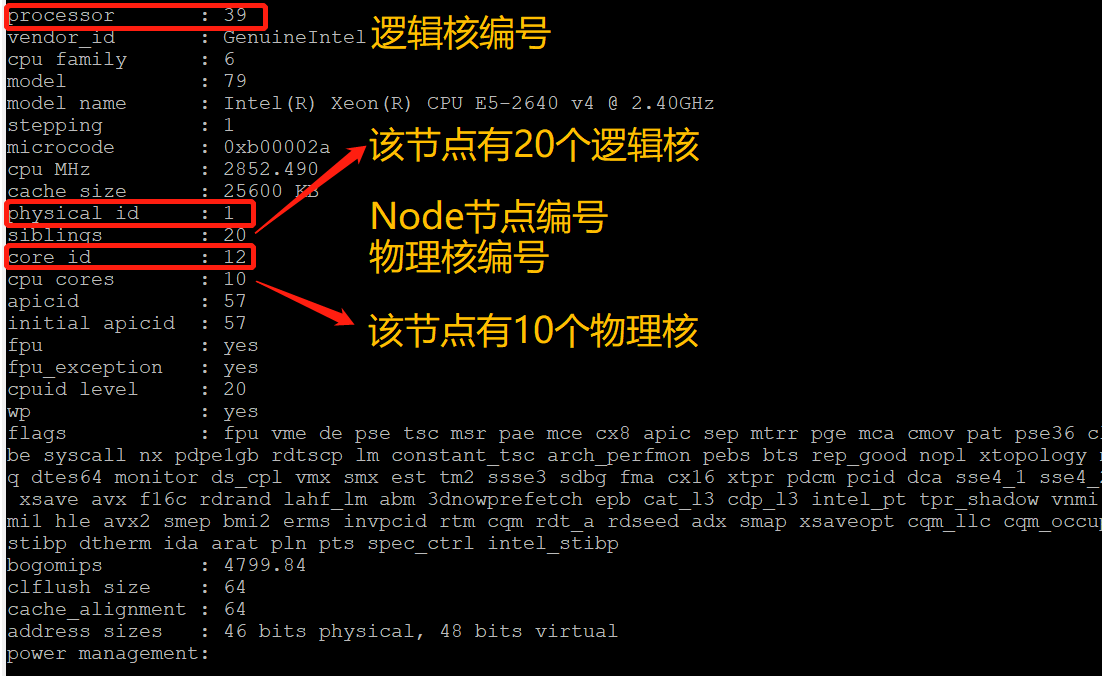
cat /proc/cpuinfo #查看所有processor的信息

core.jpg

这是最后一个逻辑核的信息,总共有40个逻辑核,该逻辑核在node1节点的12号cpu上(这里的编号不一定连续)。所有的逻辑核分布如下:

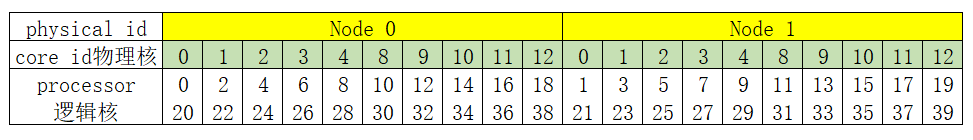
core2.jpg

因此我们设置线程时,可以绑在同一个node上,即绑在逻辑核编号为{0,2,...,18,20,22,...,38}的集合,或{1,3,...,19,21,23,...,39}的集合,让内存不要在Node0和Node1之间发生。

也可以绑在同一个core上,即绑在逻辑核编号为{0,20},{2,22},{4,24},...,或{19,39}的集合,这样不同物理核之间也不会用内存交换,提高运行速度。

可以用numactl程序查看这些核的分布情况,如没有可以安装sudo apt install numactl,但服务器上我们一般没有root权限,还可以这样查看:

cat /sys/devices/system/node/node0/cpulist
cat /sys/devices/system/node/node0/cpumap

三、设置pthread亲和性

还是用求和的例子说明:

#define _GNU_SOURCE
#include 
#include 
#include 
#include  
#include 
​
const int S = 100000000;
int* arr;
​
typedef struct{
 int first;
 int last;
 int result;
}MY_ARGS;
​
void* mysum(void* args){
 int i;
 int s=0;
 MY_ARGS* my_args = (MY_ARGS*) args;
 int first = my_args->first;
 int last = my_args->last;
​
 for(i=first;i result = s;
 return NULL;
}
​
int main(){
 int i;
 arr = malloc(sizeof(int) * S);
 for(i=0;i

这里将两个线程绑分布绑在node0和node1节点,也可以都绑在同一个节点,因为每个节点最多能跑20个线程,问题不大。

更多实例可以参看我的gitee:pthread亲和性

]]>
<![CDATA[C++多线程1——pthread]]> https://www.icfgblog.com/index.php/EDA/115.html 2021-02-08T10:31:00+08:00 2021-02-08T10:31:00+08:00 icfg66 http://www.icfgblog.com

一、多核时代

随着数字IC工艺的提升,单核性能越来越高,但随之来的是功率密度增大,芯片发热严重,要进一步提升性能,很自然会想到C多核。将计算任务分配到不同的cpu,最后将结果整合,完成多核并行。

二、C\C++的多线程

C提供了很方便的多线程库,最基本的是pthread库,C++里有thread库(调用起来更加方便),还有omp库(不必自己设置线程,已封装好),接下来将介绍C++pthread库的应用实例,这些实例能够很方便移植到不同的应用中。omp库的实例可参看C++openmp并行计算实例。

三、实例

pthread的实例参考了B站up主“正月点灯笼”的教学视频: C语言多线程程序入门教程,讲得非常通俗易懂。

假设我们有一个数组arr[],长度为1亿,元素大小为0~4的随机数,我们需要计算它的和。

为此我们可以用两个线程,一个线程计算前5千万个元素之和,另一个线程计算后5千万个元素之和,最后两种相加。

顺便比较单线程、omp的耗时,代码如下:

#include 
#include  
#include 
#include  
#include 
#define MAX_SIZE 100000000
int* arr;
​// 定义数据结构,用来传递参数
typedef struct{
 int first;
 int last;
 int result;
}MY_ARGS;
​//定义函数,给多线程调用
void* myfunc(void* args){
 int i;
 int s=0;
 MY_ARGS* my_args = (MY_ARGS*) args;
 int first = my_args->first;
 int last =  my_args->last;
​
 for(i=first;i result = s;
 return  NULL;
}

int main(){
  pthread_t th1;
  pthread_t th2;
​
  int i;
  arr = malloc(sizeof(int) * MAX_SIZE);
  int mid = MAX_SIZE/2;
  for(i=0;i

代码比较了pthread2线程,单线程,omp2线程的结果:

pth1.jpg

可见两个线程,甚至还有可能变慢,可能的原因是这里的数据连续分布,gcc的优化已经很极致。如果两个任务比较独立,并行的效果会更明显。这里只是给个pthread应用的实例。更多示例代码可以查看我的Gitee:pthread实例

]]>
<![CDATA[C++avx256指令集加速实例]]> https://www.icfgblog.com/index.php/EDA/6.html 2020-10-07T22:27:00+08:00 2020-10-07T22:27:00+08:00 icfg66 http://www.icfgblog.com

背景

avx256是x86cpu架构下实现SIMD(单指令多数据)的指令集。它能够利用cpu内部256bit的寄存器,同时对4位double或8位int类型的数操作,达到很好的加速效果。这里通过一个计算$\pi$的实例来展示其威力:

$$ \pi = 4\int_0^1\frac{1}{1+x^2}dx $$ linux系统下可以通过如下命令查看电脑是否支持avx256指令集: > cat /proc/cpuinfo | grep flags

image.png sse4就表示该指令集。

//g++ avx_pi.cpp -mavx -O2 
#include 
#include 
#include 
using namespace std; 
//正常的逐个累加运算
double compute_pi_naive(size_t dt){
	double pi = 0.0;
	double delta = 1.0/dt;
	for (size_t i =0;i

image.png 可以看出,速度提高了两倍多。

]]>
<![CDATA[C++openmp并行计算实例]]> https://www.icfgblog.com/index.php/EDA/30.html 2020-10-07T15:58:00+08:00 2020-10-07T15:58:00+08:00 icfg66 http://www.icfgblog.com C++利用内部库进行并行加速的实例,但实际效果确更慢,找不出原因。希望各路大神帮忙。

基本功能是计算$\pi$:

$$ \pi = 4\int^1_0 \frac{1}{1+x^2}dx $$ ```c //g++ avx_omp.cpp -fopenmp -O2 #include #include #include using namespace std; //正常的逐个累加运算 double compute_pi_naive(size_t dt){ double pi = 0.0; double delta = 1.0/dt; for (size_t i =0;ireturn 0;

}

![image.png](//www.icfgblog.com/usr/uploads/auto_save_image/922041a505b1b5234db46db1e348727c.png?imageMogr2/auto-orient/strip%7CimageView2/2/w/1240)

利用了四个线程,结果竟然更慢,真是无语了。

]]>
<![CDATA[MDS降维实例展示]]> https://www.icfgblog.com/index.php/EDA/54.html 2020-07-03T10:36:00+08:00 2020-07-03T10:36:00+08:00 icfg66 http://www.icfgblog.com 理论推导可以参看图像降维之MDS特征抽取方法 样例来自Multidimensional scaling

前言

MDS的理论推导已经有很多了,基本上来自周志华老师的西瓜书,但其中的细节还有许多不明白,因此希望通过matlab实例来理清所有脉络。

需要解释几点

1、输入数据

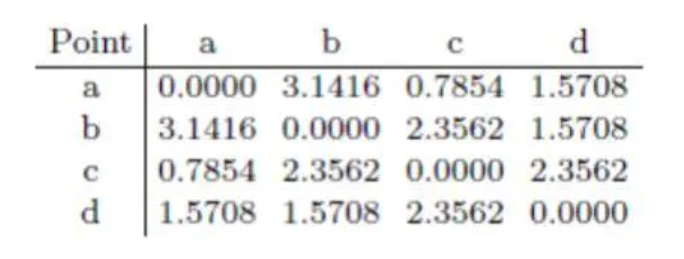
输入数据是距离矩阵D,而不是原始的m个d维向量,说明有数据的信息量缺失,但它们的相对位置关系是明确的。实例中的距离矩阵如下: 距离矩阵D

也就是有4组数据,但它们的维度不知道,姑且认为较大吧,我们的任务是找4组二维的数据$Z_{4\times 2}$,让它们间的距离和上述距离相等。

2、计算Z的内积矩阵

通过两者距离相等的关系,我们希望可以求出Z的内积矩阵$B=ZZ^T$的各个元素(这里和西瓜书不一样,因为这里的Z由行向量组成,每行表示一组数据),具体的公式有点复杂:

$$ b_{ij}=-\frac{1}{2}(distt^2_{ij}-distt^2{i.}-distt^2{.j}+dist^2) $$ 但幸运的是,这都是纸老虎,在matlab具体计算的时候,其实各部分很简单,详见后面**matal代码部分**。 #### 3、由内积矩阵获得Z 因为$B_{m\times m}$是是对称阵,可以得到m个特征值和特征向量(这里西瓜书写的是原数据的维度d,应该是不对的),特征向量从大到小排序: $$ B=V \Lambda V^T=V \Lambda ^{1/2} (V\Lambda ^{1/2})^T=ZZ^T $$ 所以$Z_{m\times m}=V\Lambda^{1/2}$。 为了实现降维,我们提取前d'个特征值和特征向量,即:$V_*=V_{m\times d'}$,$\Lambda_*=\Lambda_{d'\times d'}$。得到 $Z_{m\times d'}=V_*\Lambda_*^{1/2}$

matlab代码

clear;clc;
%输入的欧式距离对称矩阵
D=[0 3.1416 0.7854 1.5708;3.1416 0 2.3562 1.5708;
   0.7854 2.3562 0 2.3562;1.5708 1.5708 2.3562 0];
%距离平方对称阵
D2=D.*D; %每个元素为distt(ij)^2
%获得B矩阵
distt2i=mean(D2);    %对列求平均1*4矩阵
distt2j=mean(D2,2);  %对行求平均4*1矩阵
dist2=mean(mean(D2));      %所有距离的平均1*1矩阵
%matlab可以自动展开成4*4矩阵并做加减计算
B=-1/2*(D2-distt2i-distt2j+dist2);
%B=VAV'
[V,A]=eig(B);
%翻转特征向量,从特征值大到小排序
V=fliplr(V);A=wrev(diag(A));
%% 提取前两个最大的特征值,和特征向量,计算Z,实现降维
Z=V(:,1:2)*diag(sqrt(A(1:2)))

结果如下:

结果

Z剔除了部分信息后,内积矩阵与B是有差距的,但总体可以接受,最后再比较Z的4组样本间的两两距离:

两两距离比较

可以看出,整体效果还是很好的!

小结

  • 内积矩阵B的维度是$m\times m$,m为样本数量,求取得特征值和特征向量也有m个,不是d个(原样本的维度)。
  • 降维是通过选取前d'个特征值,和对应d'个特征列向量,获得$Z_{m\times d'}$。
]]>
<![CDATA[如何用带权重的蒙特卡洛计算积分?]]> https://www.icfgblog.com/index.php/physics/82.html 2020-03-23T17:58:00+08:00 2020-03-23T17:58:00+08:00 icfg66 http://www.icfgblog.com

数值积分

有时会碰到一些难以表示成一般代数形式的积分,特别是在工程上,而且工程计算时一般也不需要精确的代数表达式,往往只要一定精度的数值结果。因此如何数值计算定积分呢?

为了便于比较,我们计算如下积分:

$$ \int_0^1 \frac{1}{1+x^2}=\arctan x|_0^1=\frac{\pi}{4}\approx{0.7854} $$ ### 均匀取点
%matlab code
clear;
x=linspace(0,1,200); %平均分成200个样本
y=1./(1+x.^2);
int=mean(y) %结果为0.7852

均匀取点在积分曲线比较平缓时,效果较好,如果有变化快的地方,需要单独做更加密集的取点,这个例子中曲线比较平缓,故精度相对较高。

均匀分布的蒙特卡洛取点

%matlab code
clear;
x=rand(1,200);%产生(0,1)区间均匀分布的200个随机数
y=1./(1+x.^2);
int2=mean(y)  %结果介于0.76~0.80

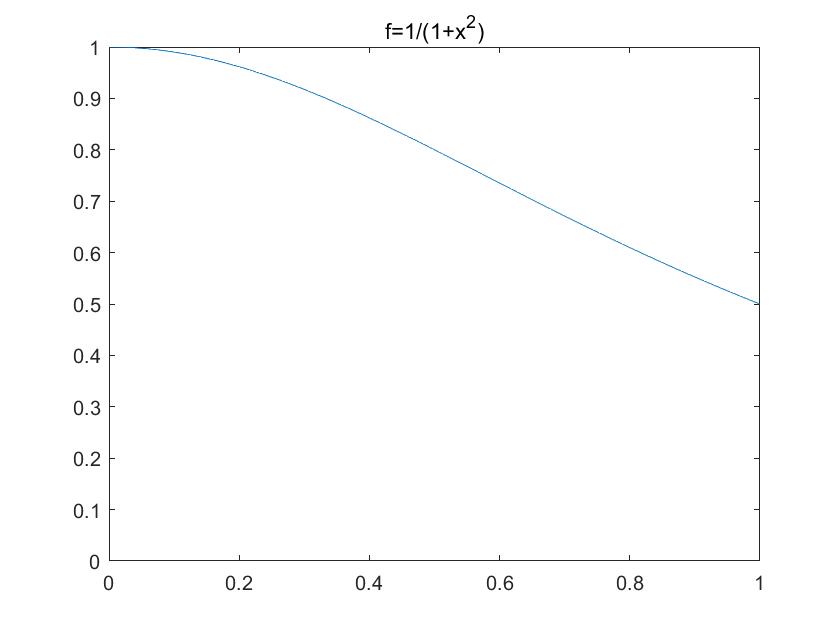
从效果上看,均匀分布的蒙特卡洛法不如均匀取点,会有涨落,精度不高,是否用更高精度的方法?观察图像$f(x)= \frac{1}{1+x^2}$: fx.jpg

我们发现函数单调递减,那么我们在蒙特卡洛取点时,是否可以在x=0附近多取一些,x=1附近少取一些?比如我们按概率密度取点:

$$ w=\frac{4}{3}(2-x) $$ 这个概率分布有以下特点:1、首先是一次函数,容易处理;2、x=0处和x=1处的概率比为2:1。最后由归一性可以确定系数。那么该如何产生这样的随机数呢?matlab有内置算法吗?请参看[Matlab如何用均匀分布产生其他分布?](https://www.jianshu.com/p/516e4fc4c7a4)
%matlab code
clear;
x=rand(1,200);
w=2-sqrt(4-3*x);
I=1./(1+w.^2)./(4-2*w)*3;
int3=mean(I)  %结果介于0.783~0.787

效果提高不少!可以猜想,如果我们选取的概率密度函数越接近原函数,那么蒙特卡洛的结果就越准确,但代价是求解反函数的过程会越复杂,需要折中。

]]>
<![CDATA[Matlab如何用均匀分布产生其他分布?]]> https://www.icfgblog.com/index.php/physics/83.html 2020-03-21T22:01:00+08:00 2020-03-21T22:01:00+08:00 icfg66 http://www.icfgblog.com

背景

Matlab有一个随机数生成函数rand(1,n),即在(0,1)区间产生均匀分布的n个随机数。如果需要在带权重的蒙特卡洛模拟中生成其他概率密度分布的随机数,该怎么办呢?能够利用均匀分布经过某种变换得到吗?

这篇笔记就是介绍如何利用均匀分布,产生其他分布,比如概率密度:

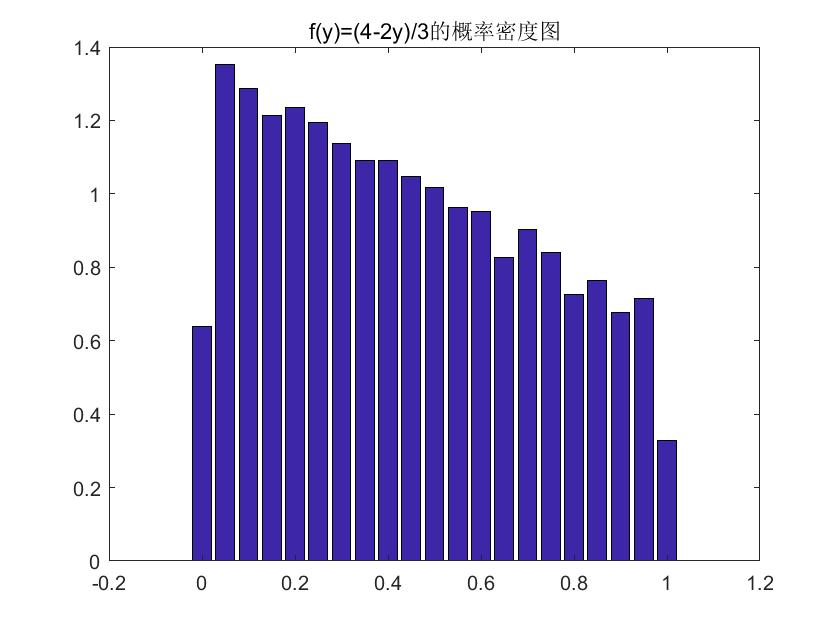
$$ f(y)=(4-2y)/3 ,y\in[0,1] $$ 具体目的是先用matlab生成[0,1]的100个随机数,然后通过什么变换,将这100个随机数做映射,而其统计结果符合上述的概率密度分布。这样做有什么意义吗?一方面能加深对概率密度间转换的理解,你会发现考研数学中统计与概率终于有用武之地!另一方面,我们如果能够产生自己所希望的概率分布的随机数,在[带权重的蒙特卡洛模拟](https://www.jianshu.com/p/6b34474fded8)中会如虎添翼,大大提高效率。

一、标准流程介绍

设随机变量X的概率分布为U(0,1),若$Y=h(X)=X^2$,求Y的概率密度分布?

先计算Y的累计分布函数,再对其求导得到Y的概率密度函数:

$$ F(y)=P(Y\leq y)=P(X^2\leq y)=P(X\leq \sqrt{y})=\sqrt{y},y\in(0,1) $$ $$ f(y)=\frac{d F(y)}{d y}=\frac{1}{2\sqrt{y}},y\in(0,1) $$ 这套流程非常标准化,也很实用,那么现在的问题是:已知f(y),如何求出h(X)?

二、实战

设随机变量X的概率分布为U(0,1),若$Y=h(X),f(y)=(4-2y)/3 ,y\in(0,1)$,那么h(x)为多少?

如果不清楚前面的标准流程,这种题目绝对会一头雾水,也多亏了考研时这方面的训练,能够比较清晰的获得解答:

$$ F(y)=P(Y\leq y)=P(h(X)\leq y)=P(X\leq h^{-1}(y))=h^{-1}(y) $$ 另一方面: $$ F(y)=\int_0^y f(y) dy=\frac{1}{3}(4y-y^2),y\in(0,1) $$ 因此需要解一个反函数: $$ h^{-1}(y)=\frac{1}{3}(4y-y^2) $$ 令$h^{-1}(y)=x$,再反解y即可,这里有点绕,需要细细品味: $$ y=2-\sqrt{4-3x}=h(x) $$ 即为所求的映射关系。 ## 三、直观呈现
% matlab 代码
clear;clc;
%产生n个(0,1)的随机数
n=10000;
x=rand(1,n);
%x的概率密度统计图
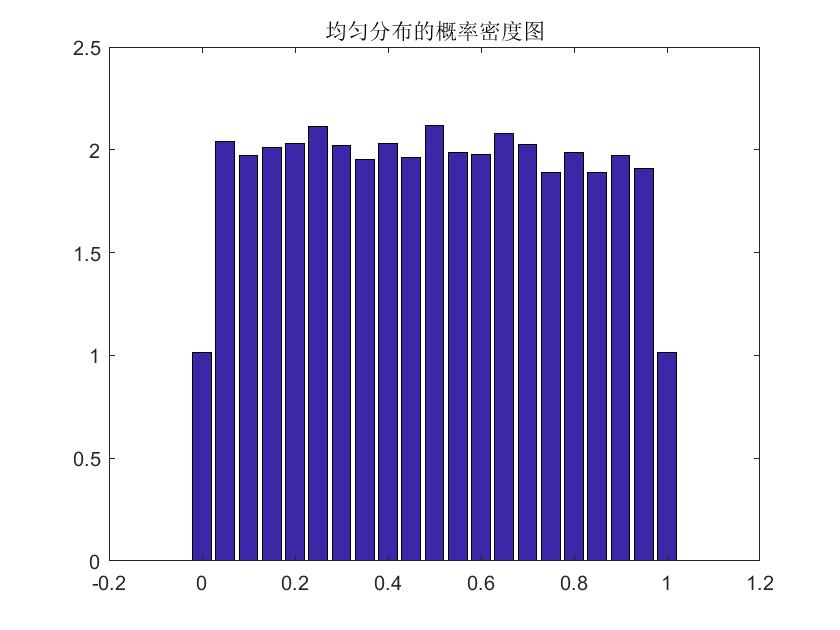
xx=linspace(0,1,21);%将最大最小区间分成21个等分点(20等分),然后分别计算各个区间的个数
yy=hist(x,xx)/n/0.05;%计算各个区间的概率密度
bar(xx,yy)%画出均匀分布的概率密度分布图
%%
y=2-sqrt(4-3*x);
yy2=hist(y,xx)/n/0.05;%计算各个区间的概率密度
bar(xx,yy2)%画出特定分布概率密度分布图

均匀分布.jpg 特定分布.jpg

更精彩的应用请参考:如何用带权重的蒙特卡洛计算积分?

]]>