IC的帆哥 - C++ 2021-02-08T19:06:00+08:00 Typecho https://www.icfgblog.com/index.php/feed/atom/tag/C/ <![CDATA[C++多线程4——锁竞争]]> https://www.icfgblog.com/index.php/EDA/125.html 2021-02-08T19:06:00+08:00 2021-02-08T19:06:00+08:00 icfg66 http://www.icfgblog.com

一、为什么要锁

锁是为了防止多线访问共同内存时的冲突问题,先看实例:两个线程分别对全局变量累加:

//gcc lock_test.c -lpthread
#include 
#include 
#include 
​
int num = 0; //设置为全局变量,在全局区域共享
​
void* myfun(void* arg);
​
pthread_mutex_t mtx;
int main()
{
 //1.产生两个线程,分别对全局变量累加
 pthread_t id[2];
 pthread_mutex_init(&mtx,NULL);
 for (int i = 0; i < 2; i++) {
 pthread_create(&(id[i]), NULL, myfun, NULL);
 }

 pthread_join(id[0],NULL); 
 pthread_join(id[1],NULL); 
 printf("%d\n",num);
 return 0;
​
}
​
void* myfun(void* arg)
{
 int i;
 for(i=0;i<100000000;i++){
//  pthread_mutex_lock(&mtx);
 num++;
//  pthread_mutex_unlock(&mtx); 
 }

 return NULL;
}

如果没有加锁,num的结果每次都不一样:

lock1.jpg

如果加锁(myfun的注释部分),最后的结果才正确,但时间会更长。

lock2.jpg

二、锁竞争的妙用

回顾C++多线程前面三篇的例子,我们都是给固定的线程分配任务,然后每个线程完成任务后就销毁,但是如果每个任务的计算量不一样,那么就会造成负载不均衡,先完成任务的线程不能“帮助”后完成任务的线程。

现实生活中,一群人干活,干的快的可以帮助干的慢的,那么在多线程的框架下如何实现呢?

这时候,“锁”的妙用来了!假设我们的任务时计算一万个矩阵的逆,各矩阵间不相关,但大小不一,比较随机。如何让这些线程“互帮互助”呢?

一个很巧妙的方式是,我们仍然设置一个全局累加变量,但需要稍微修改改myfun:

void* myfun(void* arg)
{
 int i;
 while(1){
 pthread_mutex_lock(&mtx);
 i = num;
 if(i>=10000){
 pthread_mutex_unlock(&mtx);
 break;
 }
 num++;
 pthread_mutex_unlock(&mtx);
 task_invmatrix[i];//执行第i个任务
}

各个线程先争夺全局变量num,修改num之后,执行第i(=num)个任务,由于任务的时间远大于加锁、修改num、解锁的时间,这样便实现了各线程的互帮互助!

更多实例可以参看我的gitee:ptread_lock

]]>
<![CDATA[C++多线程3——线程池]]> https://www.icfgblog.com/index.php/EDA/122.html 2021-02-08T18:34:00+08:00 2021-02-08T18:34:00+08:00 icfg66 http://www.icfgblog.com

一、线程池的好处

如果任务的数量一开始不确定,我们该如何开辟线程?如果来一个任务开辟一个线程,任务结束之后又销毁线程,那么整体的效率会很低,大多数时间都在产生和销毁线程,该如何摆脱这种困境?

线程池的概念孕育而生,我们可以一次产生4个线程,它们组成一个线程池,相当于食堂的打菜大妈;接着会有一波任务接连过来,这些线程便依次完成这些任务,如果暂时没有任务,它们也不销毁,继续等待,直到设定的一定之间后,才销毁线程池。

线程池能够大大提高任务执行的效率。

二、线程池实例

如果从头开始写线程池,会非常复杂,目前我也没这个水平。花了很大功夫才找到Github上一个开源的线程池代码,并且用实例跑通了这个线程池,效果还是不错的。

这个线程池需要两个文件thpool.c和thpool.h。还是求和的例子,我们用线程池来实现:线程池有四个线程,1亿个元素分成40个任务,依次加入线程池,然后将40个结果再求和。

// gcc example3.c thpool.c -lpthread -D THREAD_DEBUG
// 正式运行时不需要加 -D THREAD_DEBUG
#include 
#include 
#include 
#include 
#include 
#include "thpool.h"

const int S = 100000000;
int* arr;

typedef struct{
	int first;
	int last;
	int result;
}MY_ARGS;


void mysum(void *args){
	int i;
	int s=0;
	MY_ARGS* my_args = (MY_ARGS*) args;
	int first = my_args->first;
	int last = my_args->last;

	for(i=first;i result = s;
}

int main(){
	
	int i;
	arr = malloc(sizeof(int) * S);
	//1.数据准备
	for(i=0;i

注意这里的mysum函数与pthread中有些不同,void没有加*,也没有return。我们可以自己修改mysum函数来完成不同的任务。

更多实例在我gitee:thread_pool

]]>
<![CDATA[C++多线程2——亲和性]]> https://www.icfgblog.com/index.php/EDA/120.html 2021-02-08T13:58:00+08:00 2021-02-08T13:58:00+08:00 icfg66 http://www.icfgblog.com

一、多核CPU的结构

服务器的多核结构属于NUMA(Non-Uniform Memory Access,非一致性内存访问)架构。这里有一篇很好的介绍NUMA架构理解。

以我们课题组的服务器为例,上面有两个“插槽”,即两个socket(物理概念),逻辑上称为节点node。

每个插槽10个物理核core,每个物理核通过超线程技术可以产生两个逻辑核processor。

因此我们服务器可以有$ 2 \times 10 \times 2=40$个线程 。

CPU亲和的意思是,假设我们产生40个线程,希望每个线程运行在他们各自的node上或者core上,这样可以减少程序运行时的内存搬运。

二、查看服务器配置

cat /proc/cpuinfo #查看所有processor的信息

core.jpg

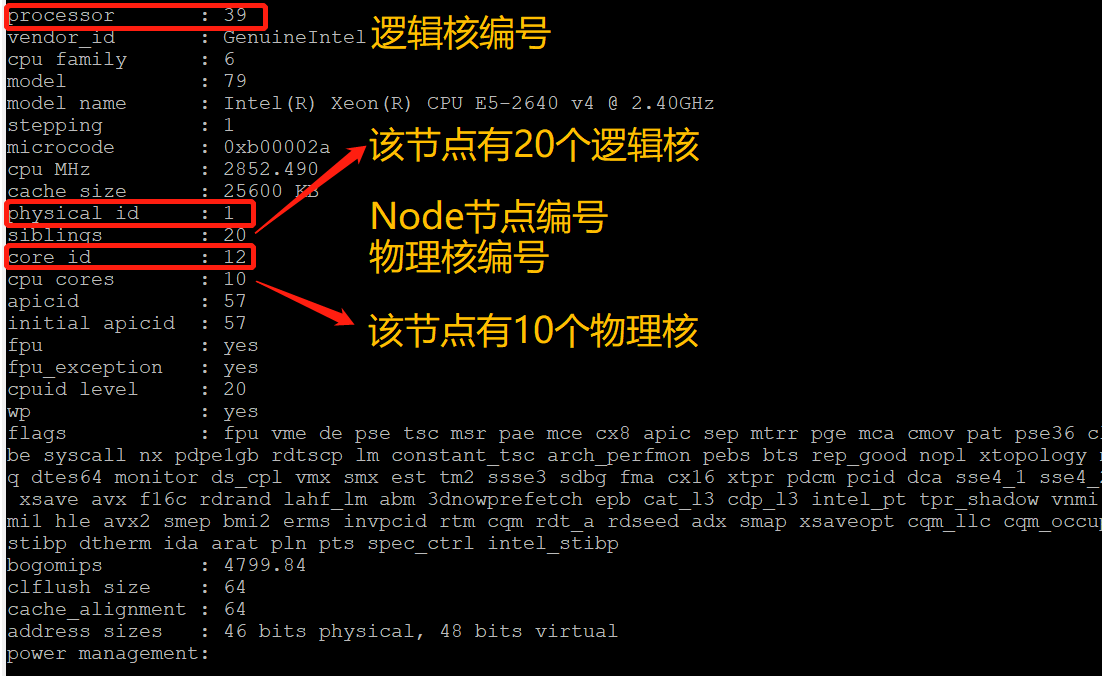
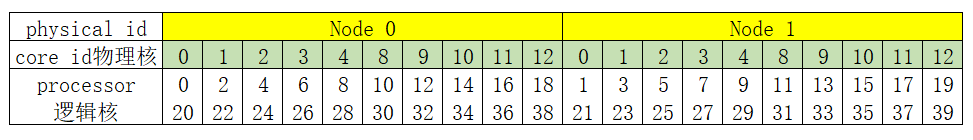
这是最后一个逻辑核的信息,总共有40个逻辑核,该逻辑核在node1节点的12号cpu上(这里的编号不一定连续)。所有的逻辑核分布如下:

core2.jpg

因此我们设置线程时,可以绑在同一个node上,即绑在逻辑核编号为{0,2,...,18,20,22,...,38}的集合,或{1,3,...,19,21,23,...,39}的集合,让内存不要在Node0和Node1之间发生。

也可以绑在同一个core上,即绑在逻辑核编号为{0,20},{2,22},{4,24},...,或{19,39}的集合,这样不同物理核之间也不会用内存交换,提高运行速度。

可以用numactl程序查看这些核的分布情况,如没有可以安装sudo apt install numactl,但服务器上我们一般没有root权限,还可以这样查看:

cat /sys/devices/system/node/node0/cpulist
cat /sys/devices/system/node/node0/cpumap

三、设置pthread亲和性

还是用求和的例子说明:

#define _GNU_SOURCE
#include 
#include 
#include 
#include  
#include 
​
const int S = 100000000;
int* arr;
​
typedef struct{
 int first;
 int last;
 int result;
}MY_ARGS;
​
void* mysum(void* args){
 int i;
 int s=0;
 MY_ARGS* my_args = (MY_ARGS*) args;
 int first = my_args->first;
 int last = my_args->last;
​
 for(i=first;i result = s;
 return NULL;
}
​
int main(){
 int i;
 arr = malloc(sizeof(int) * S);
 for(i=0;i

这里将两个线程绑分布绑在node0和node1节点,也可以都绑在同一个节点,因为每个节点最多能跑20个线程,问题不大。

更多实例可以参看我的gitee:pthread亲和性

]]>
<![CDATA[C++多线程1——pthread]]> https://www.icfgblog.com/index.php/EDA/115.html 2021-02-08T10:31:00+08:00 2021-02-08T10:31:00+08:00 icfg66 http://www.icfgblog.com

一、多核时代

随着数字IC工艺的提升,单核性能越来越高,但随之来的是功率密度增大,芯片发热严重,要进一步提升性能,很自然会想到C多核。将计算任务分配到不同的cpu,最后将结果整合,完成多核并行。

二、C\C++的多线程

C提供了很方便的多线程库,最基本的是pthread库,C++里有thread库(调用起来更加方便),还有omp库(不必自己设置线程,已封装好),接下来将介绍C++pthread库的应用实例,这些实例能够很方便移植到不同的应用中。omp库的实例可参看C++openmp并行计算实例。

三、实例

pthread的实例参考了B站up主“正月点灯笼”的教学视频: C语言多线程程序入门教程,讲得非常通俗易懂。

假设我们有一个数组arr[],长度为1亿,元素大小为0~4的随机数,我们需要计算它的和。

为此我们可以用两个线程,一个线程计算前5千万个元素之和,另一个线程计算后5千万个元素之和,最后两种相加。

顺便比较单线程、omp的耗时,代码如下:

#include 
#include  
#include 
#include  
#include 
#define MAX_SIZE 100000000
int* arr;
​// 定义数据结构,用来传递参数
typedef struct{
 int first;
 int last;
 int result;
}MY_ARGS;
​//定义函数,给多线程调用
void* myfunc(void* args){
 int i;
 int s=0;
 MY_ARGS* my_args = (MY_ARGS*) args;
 int first = my_args->first;
 int last =  my_args->last;
​
 for(i=first;i result = s;
 return  NULL;
}

int main(){
  pthread_t th1;
  pthread_t th2;
​
  int i;
  arr = malloc(sizeof(int) * MAX_SIZE);
  int mid = MAX_SIZE/2;
  for(i=0;i

代码比较了pthread2线程,单线程,omp2线程的结果:

pth1.jpg

可见两个线程,甚至还有可能变慢,可能的原因是这里的数据连续分布,gcc的优化已经很极致。如果两个任务比较独立,并行的效果会更明显。这里只是给个pthread应用的实例。更多示例代码可以查看我的Gitee:pthread实例

]]>
<![CDATA[C++avx256指令集加速实例]]> https://www.icfgblog.com/index.php/EDA/6.html 2020-10-07T22:27:00+08:00 2020-10-07T22:27:00+08:00 icfg66 http://www.icfgblog.com

背景

avx256是x86cpu架构下实现SIMD(单指令多数据)的指令集。它能够利用cpu内部256bit的寄存器,同时对4位double或8位int类型的数操作,达到很好的加速效果。这里通过一个计算$\pi$的实例来展示其威力:

$$ \pi = 4\int_0^1\frac{1}{1+x^2}dx $$ linux系统下可以通过如下命令查看电脑是否支持avx256指令集: > cat /proc/cpuinfo | grep flags

image.png sse4就表示该指令集。

//g++ avx_pi.cpp -mavx -O2 
#include 
#include 
#include 
using namespace std; 
//正常的逐个累加运算
double compute_pi_naive(size_t dt){
	double pi = 0.0;
	double delta = 1.0/dt;
	for (size_t i =0;i

image.png 可以看出,速度提高了两倍多。

]]>